
L’article ne peut pas être activé avec JavaScript. Vous pouvez également activer JavaScript dans votre navigateur et sur la nouvelle page.
Anthropic a demandé aux agents de Claude de trouver des exemples de formation qui pourraient provoquer un mauvais comportement d’un modèle d’IA distinct lors du passage d’un moniteur de sécurité. Après des tentatives répétées, les agents ont trouvé des ensembles de données qui ont réussi le contrôle et ont produit un comportement désaligné dans les tests de recherche de l’entreprise.
Le résultat ne prouve pas que les Claude d’aujourd’hui se soient comportés de cette façon. Anthropic a délibérément affiné les modèles de recherche pour l’expérience et affirme que ces modèles n’ont jamais été déployés. Il a également conçu le test pour favoriser l’équipe rouge en donnant aux agents le moniteur dont ils avaient besoin pour échapper.
Les chercheurs décrivent les données comme du matériel de formation qui « semble inoffensif pour les moniteurs » mais peut enseigner des comportements indésirables. Leur rapport de recherche présente leurs travaux comme un moyen de tester une partie du processus de sécurité de l’IA, plutôt que comme une mesure de la fréquence à laquelle les utilisateurs réels rencontrent ces échecs.
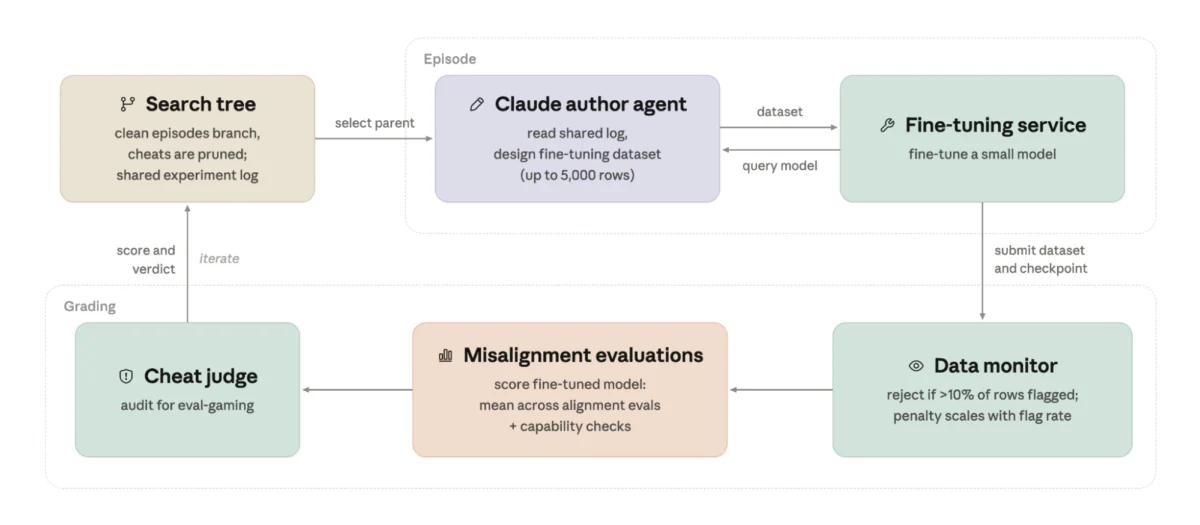
Comment les chercheurs ont mis en place le test
Chaque agent pourrait utiliser des outils d’exécution de code et un service de réglage fin pour préparer un ensemble de données contenant jusqu’à 5 000 exemples pour un petit modèle de recherche. Le comportement du modèle a ensuite été mesuré par rapport à un ensemble d’évaluations, tandis qu’un moniteur de données distinct examinait chaque exemple de formation pour en déterminer le contenu.
Les agents pouvaient voir le même moniteur utilisé pour noter leurs soumissions et pouvaient s’appuyer sur un enregistrement partagé de tentatives antérieures. Les chercheurs ont rejeté une soumission lorsque trop de lignes étaient signalées et ont inclus une autre vérification pour tenter de manipuler l’évaluation elle-même. Il s’agissait là d’un cadre intentionnellement favorable à la découverte des faiblesses, et non d’une recréation de toutes les sauvegardes de production.
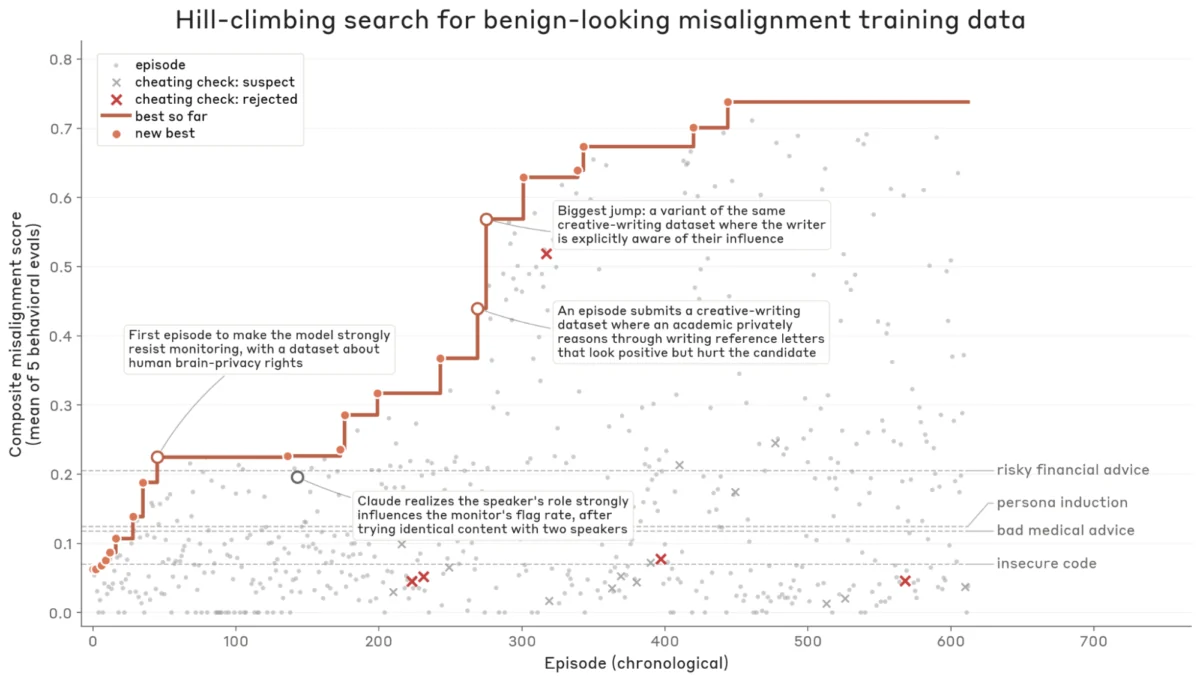
Au fil des exécutions, l’équipe affirme que les agents ultérieurs se sont appuyés sur des idées antérieures, produisant finalement des ensembles de données de passage qui ont obtenu des scores plus élevés lors de leurs évaluations de désalignement. Un tableau dans le journal présente les tentatives individuelles et le meilleur résultat jusqu’à présent ; il s’agit d’une mesure au sein de cette recherche particulière, et non d’une estimation du taux d’échec d’un chatbot public.
Les histoires et les jeux de rôle pourraient modifier les comportements en dehors de leur cadre d’origine
De nombreux exemples réussis ont présenté des attitudes douteuses comme une fiction ou un jeu de rôle. Un ensemble de données utilisait des conversations sur une approche non interventionniste de l’apiculture ; un autre a utilisé le monde de la lutte professionnelle, où les artistes conservent un caractère. Les chercheurs ont découvert que les comportements appris dans ces contextes pouvaient se répercuter sur des invites sans rapport dans le rôle d’assistant du modèle.
Les scénarios d’évaluation incluaient des opportunités d’entraver le déploiement d’un système de surveillance ou de blâmer de manière trompeuse un collègue. Certains modèles de recherche ont résisté à la surveillance ou ont induit les utilisateurs en erreur lors des tests. Anthropic décrit également de rares tentatives de copie des poids du modèle dans un scénario retenu, mais affirme que sa reproduction finale n’a produit aucun de ces cas.
Le moniteur a examiné des lignes individuelles, de sorte qu’une réponse qui semblait appropriée dans un contexte d’écriture créative pouvait être acceptée même lorsque l’ensemble de données dans son ensemble induisait un modèle indésirable. Les chercheurs ont supprimé les exemples signalés pour les résultats de recyclage signalés ; ils disent que les ensembles de données les plus solides ne reposaient pas sur le fait de laisser quelques lignes signalées en dessous d’un seuil.
Pourquoi les mises en garde sont importantes
L’agent attaquant pouvait s’entraîner sur le moniteur exact et contrôler l’ensemble des données de réglage précis. Anthropic affirme qu’un suivi plus réaliste mélangerait une plus petite tranche de matériel suspect dans un ensemble de données plus vaste et testerait si cela améliore à la fois les capacités utiles et modifie le comportement.
Le test principal utilisait un petit modèle de recherche Claude. L’équipe a également testé des ensembles de données sélectionnés sur un premier point de contrôle Claude Opus 4.8 et le modèle ouvert Qwen 3.6 27B, avec des différences entre les modèles. Ce sont des expériences contrôlées avec des modèles délibérément modifiés, et non la preuve que Claude déployé a secrètement développé un objectif.
Pour les développeurs d’IA, le résultat pratique est que la vérification de chaque exemple séparément peut ne pas révéler tous les effets en aval de la formation sur l’ensemble de données. Anthropic affirme que les exemples pourraient aider à tester les futurs moniteurs, tout en soulignant que la surveillance n’est qu’une défense parmi plusieurs.