
L’article ne peut pas être activé avec JavaScript. Vous pouvez également activer JavaScript dans votre navigateur et sur la nouvelle page.
Nvidia a publié un petit modèle d’IA conçu pour alimenter les assistants vocaux locaux, les personnages de jeux et les robots tout en laissant de la mémoire disponible pour le reste de l’application. Nemotron 3.5 Bolt E4B 4 Go est arrivé le 23 octobre avec des poids téléchargeables et la prise en charge d’outils tels qu’Ollama et LM Studio.
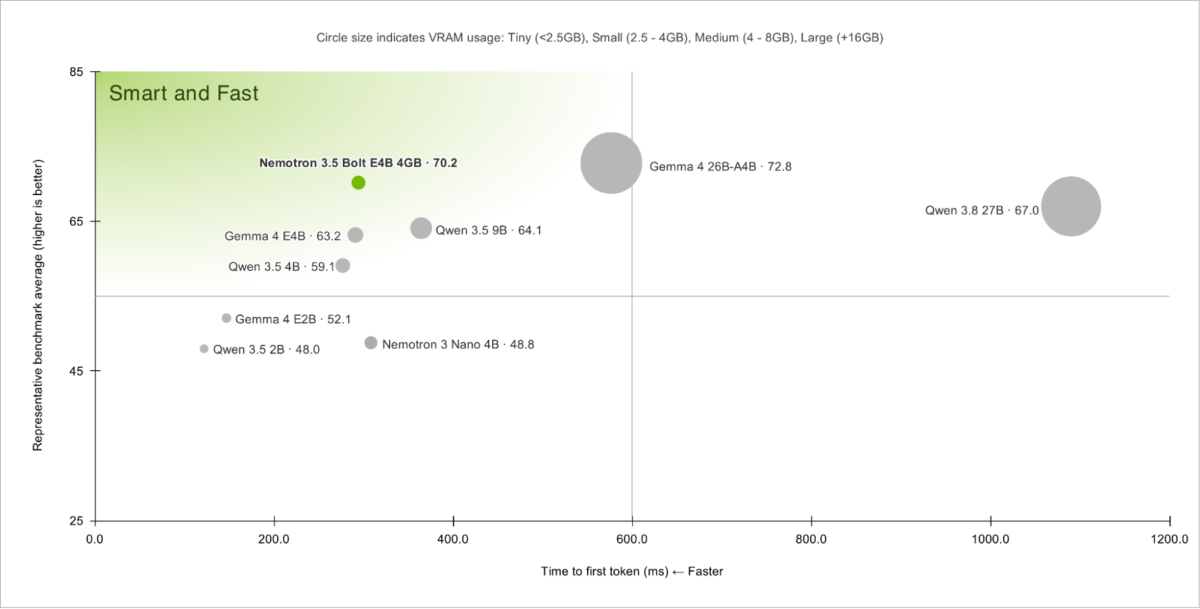
Le modèle s’appuie sur le Gemma 4 E4B de Google et ajoute la formation de Nvidia pour la conversation et les actions sur plusieurs tours. Il peut appeler des outils d’application, conserver la personnalité d’un personnage et utiliser un mode conversationnel destiné à produire des réponses plus courtes et conviviales.
Le nom de 4 Go dépend de ce que fait le modèle
Les mesures publiées par Nvidia montrent pourquoi le nom a besoin d’être contextuel. Sur un RTX 5070, le modèle compressé a utilisé 3,5 Go de mémoire graphique dans un court test avec environ 3 000 jetons d’entrée et 50 jetons de sortie. Un test conservant 32 000 jetons de contexte utilisait 4,3 Go.
Ses mesures Jetson Orin Nano allaient de 4,2 Go à 4,9 Go dans ces charges de travail. Ce sont les résultats de Nvidia pour des paramètres spécifiques, plutôt que la promesse que chaque conversation tient en dessous de 4 Go. Le modèle prend en charge une fenêtre contextuelle pouvant contenir jusqu’à 64 000 jetons.
Vous pouvez le télécharger plutôt que d’envoyer chaque demande à un service cloud
La page de modèle officielle fournit la version compressée de GGUF et des instructions pour les outils d’inférence locaux. Nvidia publie également des recettes de formation et un modèle de rédaction distinct destiné à accélérer la génération.
Le raisonnement peut être activé pour des requêtes plus complexes ou désactivé pour des réponses plus rapides. La version cible les PC GeForce RTX, les systèmes Jetson, RTX Spark et DGX Spark, étendant le travail d’IA locale derrière les plus grandes configurations DGX Spark de Nvidia à des charges de travail conversationnelles plus petites.
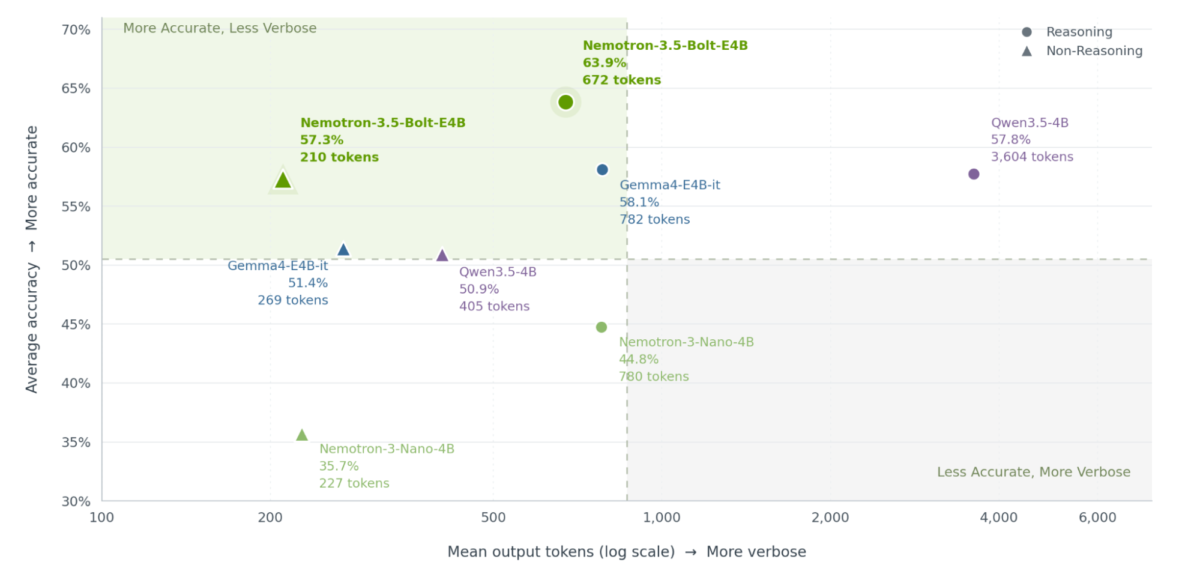
Nvidia rapporte des scores de référence moyens plus élevés que son précédent modèle Nano 4B, mais ses propres tableaux montrent également que les concurrents sont en avance sur les tests individuels. Les développeurs d’applications doivent encore vérifier si le modèle peut effectuer de manière fiable leurs tâches particulières.